一、导语
2026 年 7 月 31 日,字节跳动 Seed 团队正式发布新一代视频创作模型 Seedance 2.5。最直观的变化是单次生成时长从 Seedance 2.0 的 15 秒 翻倍至 30 秒,同时支持多轮延长、单次最多 30 张图片 + 10 段视频 + 10 段音频 的多模态参考,以及基于时间戳的精准编辑。官方称其「重点突破长叙事能力、多模态参考能力和编辑能力」,并已在即梦 AI、豆包专业版上线,API 将于近期登陆火山方舟。
视频生成赛道过去两年的竞争焦点一直在「单段画质」——谁生成的镜头更真实、更流畅。Seedance 2.5 则把火力转向了另一个维度:能不能一次生成一个完整的故事。这可能是视频大模型从「素材工具」走向「创作工具」的分水岭。
二、背景分析:为什么这个版本重要?
Seedance 系列是字节跳动在视频生成领域的主力模型。Seedance 2.0 于 2025 年 发布,其「统一多模态音视频联合生成架构」首次把画面、音效、对白、音乐放进同一个生成流程,避免了过去「先生成视频、再单独配音」造成的音画割裂。这一代产品帮助字节系在即梦 AI、剪映等产品中快速落地,也让字节成为国内视频生成的第一梯队玩家。
但 2.0 时代的行业共识是:15 秒 单段生成对短视频剪辑够用,对剧情片、广告片、影视预览这类「长叙事」场景远远不够。用户被迫把一段 60 秒的内容拆成 4 段生成,再在剪辑软件里手动拼接——镜头衔接、人物一致性、光线统一都成了痛点。
Seedance 团队在官方博客中明确指出了这一观察:
「Seedance 2.0 发布后,我们观察到,用户对视频创作模型的期待正在从『生成一个片段』走向『完成一段创作』。」
这句话基本概括了 Seedance 2.5 的全部设计逻辑:与其把单段画质再卷高一点,不如解决创作流程中真正卡脖子的环节——时长、可控性和连续性。
三、核心内容:Seedance 2.5 的三板斧
1. 单次 30 秒 + 多轮延长:长叙事成为可能
Seedance 2.5 将单次生成时长提升至 30 秒,并能在已有成片上自然衔接后续镜头(多轮延长),最终产出数分钟、具有统一视听语言的连贯内容。官方演示中,模型能在一镜到底的场景里组织「铺垫—推进—转折—收尾」的完整叙事,例如歌手从化妆间与工作人员互动、穿过后台走廊与伴舞相遇、最终登台演出的完整故事线。
为了保证长视频质量,模型优化了镜头衔接与场景过渡,并系统处理了视频生成常见的「油腻感」——物体材质、人物肤质与眼神、光影、画面饱和度都被单独调校,字幕与背景音乐不再失控。用官方的话说,成片「更接近实拍的影视质感」。
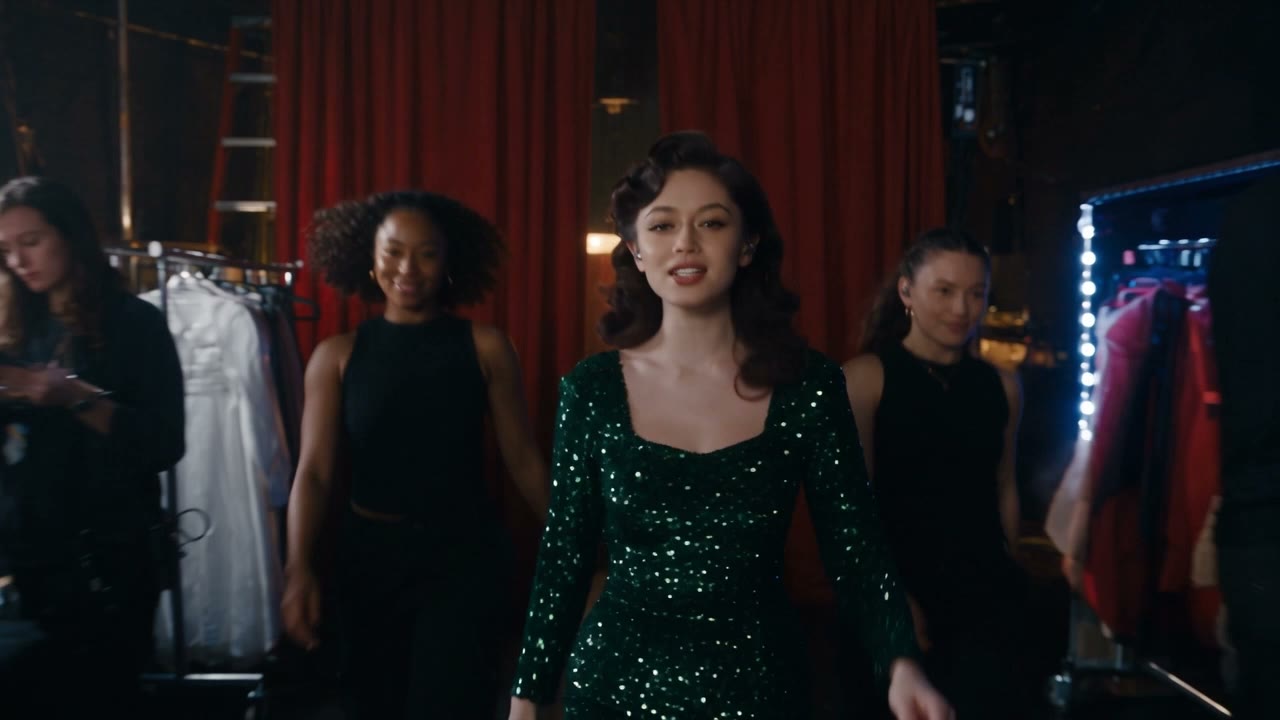
2. 多模态参考全面升级:30 图 + 10 视频 + 10 音频
参考能力是 Seedance 2.5 升级最猛的一块。单次输入最多支持 30 张图片、10 段视频、10 段音频 作为参考素材,模型需要综合理解不同素材中的构图、场景、风格、人物、道具,再按指令生成。这意味着用户可以把「角色设定图 + 场景参考 + 动作视频 + 配音音频」一次性丢给模型,在多人同框、群像叙事等复杂场景中同时还原多个人物的形象与声音。
此外还有三类细化能力:
- 白模参考:用无纹理 3D 模型搭出空间结构、主体姿态、运动轨迹和机位,模型据此生成符合真实物理规律的光照(光源方向、色温、强度、阴影投射)
- 运动参考:锁定动作与运镜方式
- 创意参考:约束风格与叙事氛围
3. 时间戳精准编辑:生成后也能改
Seedance 2.5 支持通过时间戳精准编辑音视频内容。生成前,用户可用 prompt 控制某时间段的故事、视角、运镜与节奏;生成后,还能针对指定片段的角色、动作、声音或剧情做定向修改,且保持前后连贯。绿幕编辑、视角与运镜编辑、参考编辑等能力同步增强——例如绿幕场景中,人物衣服飘动方向、头发状态、步态节奏、光影都会基于新场景的物理规则重新渲染。
四、各方反应
发布当天,Seedance 2.5 即登上 AI 热点榜榜首(本站数据评分 80,为当日最高)。行业关注点集中在三处:
创作者侧:广告与短视频从业者最关心 30 秒单次生成对工作流的改变——过去一条 30 秒口播+空镜混剪需要生成 6-10 段素材,现在理论上两段即可完成,拼接成本大幅下降。「一镜成片,随心参考」的官方 slogan 直指这个场景。
竞争格局:视频生成赛道的头部玩家几乎在同一窗口期发力。MiniMax 于同日发布开源多模态生成模型 H3(支持 2K 原生立体声视频),快手可灵、智谱清影等也在迭代长视频能力。国内视频大模型在「长叙事 + 多模态输入」上的军备竞赛已经白热化。
观察者观点:有分析指出,Seedance 2.5 的定价与落地节奏(即梦 AI、豆包专业版即时可用,API 紧随其后)延续了字节一贯的「应用先行」策略——不急着证明基准分,先让用户在真实创作场景里用起来。
「视频生成的分水岭不在画质了,在你能不能一次讲完一个故事。Seedance 2.5 把单段做到 30 秒,等于把拼接成本从用户手里拿回给了模型。」
五、深度解读:这意味着什么?
长叙事是下一阶段的入场券
回顾视频生成模型的能力演进:2023 年 是「能动」(4-10 秒短视频),2024-2025 年 是「能看」(画质、物理合理性、音画同步),到了 2026 年,竞争焦点正在转向「能讲」——模型需要在几十秒甚至几分钟内保持人物、场景、风格、叙事的连贯。Seedance 2.5 的 30 秒 + 多轮延长,本质上是把「镜头语言」的掌控权交给模型,而不是让用户用剪辑软件补救。
多模态参考 = 可控性才是生产力
30 图 + 10 视频 + 10 音频的参考上限,反映出一个务实判断:创作者不缺「灵光一现」,缺的是「把脑海里的画面稳定复现」的能力。白模参考尤其值得注意——它把 3D 预演(previs)这种影视工业流程直接下沉到普通用户,构图和调度从「碰运气」变成「可预期」。
对工具站读者的实用建议
如果你在即梦 AI 或豆包专业版创作:优先用「多图参考 + 时间戳 prompt」组合做分镜预演;做口播/广告时利用 30 秒单段能力减少拼接;人物一致性要求高的项目,把角色设定图一次喂满 30 张的上限。API 上线火山方舟后,批量生成与程序化创作的成本结构还会再变。
当然也要泼一盆冷水:单次 30 秒的算力成本显著高于 15 秒,商用 API 定价尚未公布;「多轮延长」的长视频一致性在真实复杂场景下能撑几分钟,仍需观察。Seedance 2.5 的方向是对的,但距离「全片 AI 生成」还有距离。
六、总结
Seedance 2.5 用「单次 30 秒 + 最多 30 图参考 + 时间戳编辑」三件事,把视频生成从素材工具推进到了创作工具的临界点——当模型能一次讲完一个故事,剪辑软件里最贵的部分(拼接与调校)正在被重构。