一、导语
2026 年 8 月,智谱正式发布 GLM-5.3。这是一次「换芯不换基座」的升级:模型基座与 GLM-5.2 完全相同,全部提升都来自后训练(Post-training)Scaling——数十倍的长程任务环境、更丰富的环境类型、超长的强化学习训练时间。结果令人瞩目:内部体感评测中编程能力较 GLM-5.2 提升 50%,AA 智能指数 60 分并列开源第一,同时在漏洞挖掘等网络安全任务上表现持平闭源前沿模型 Mythos 5。智谱计划在发布两周后开放完整模型权重,官方口径是「先完成安全评估与模型加固」。
二、背景分析:为什么这件事重要?
过去一年的开源模型竞争几乎都在「基座」层面展开:更大参数、更多训练数据、更强的预训练算力。但 GLM-5.3 给出了另一种叙事——基座不动,靠后训练把智能上界推高。智谱在技术博客中明确表示:「可能我们还远未开发出这个基座的智能上界。」这句话背后的行业背景是:DeepSeek V4 Pro 与 Grok 4.6 同日发布(8 月 13 日),Qwen3.8 系列、dots3-note 等开源模型密集上线,OpenAI 与 Anthropic 正在与中国对手打价格战——开源模型在编程与 Agent 任务上逼近闭源前沿,已经不再是口号。
前置条件同样关键:2025 年 9 月,智谱开始在网络安全方向投入研究;GLM-5.2 与 GLM-5.3 研发期间,与国内多家头部安全实验室共建长程任务环境与评测框架。也就是说,GLM-5.3 的「安全能力」不是临时包装的卖点,而是长达近一年、有组织的能力建设结果。
三、核心内容:GLM-5.3 到底强在哪
1. 编程能力:公开基准全面开源第一
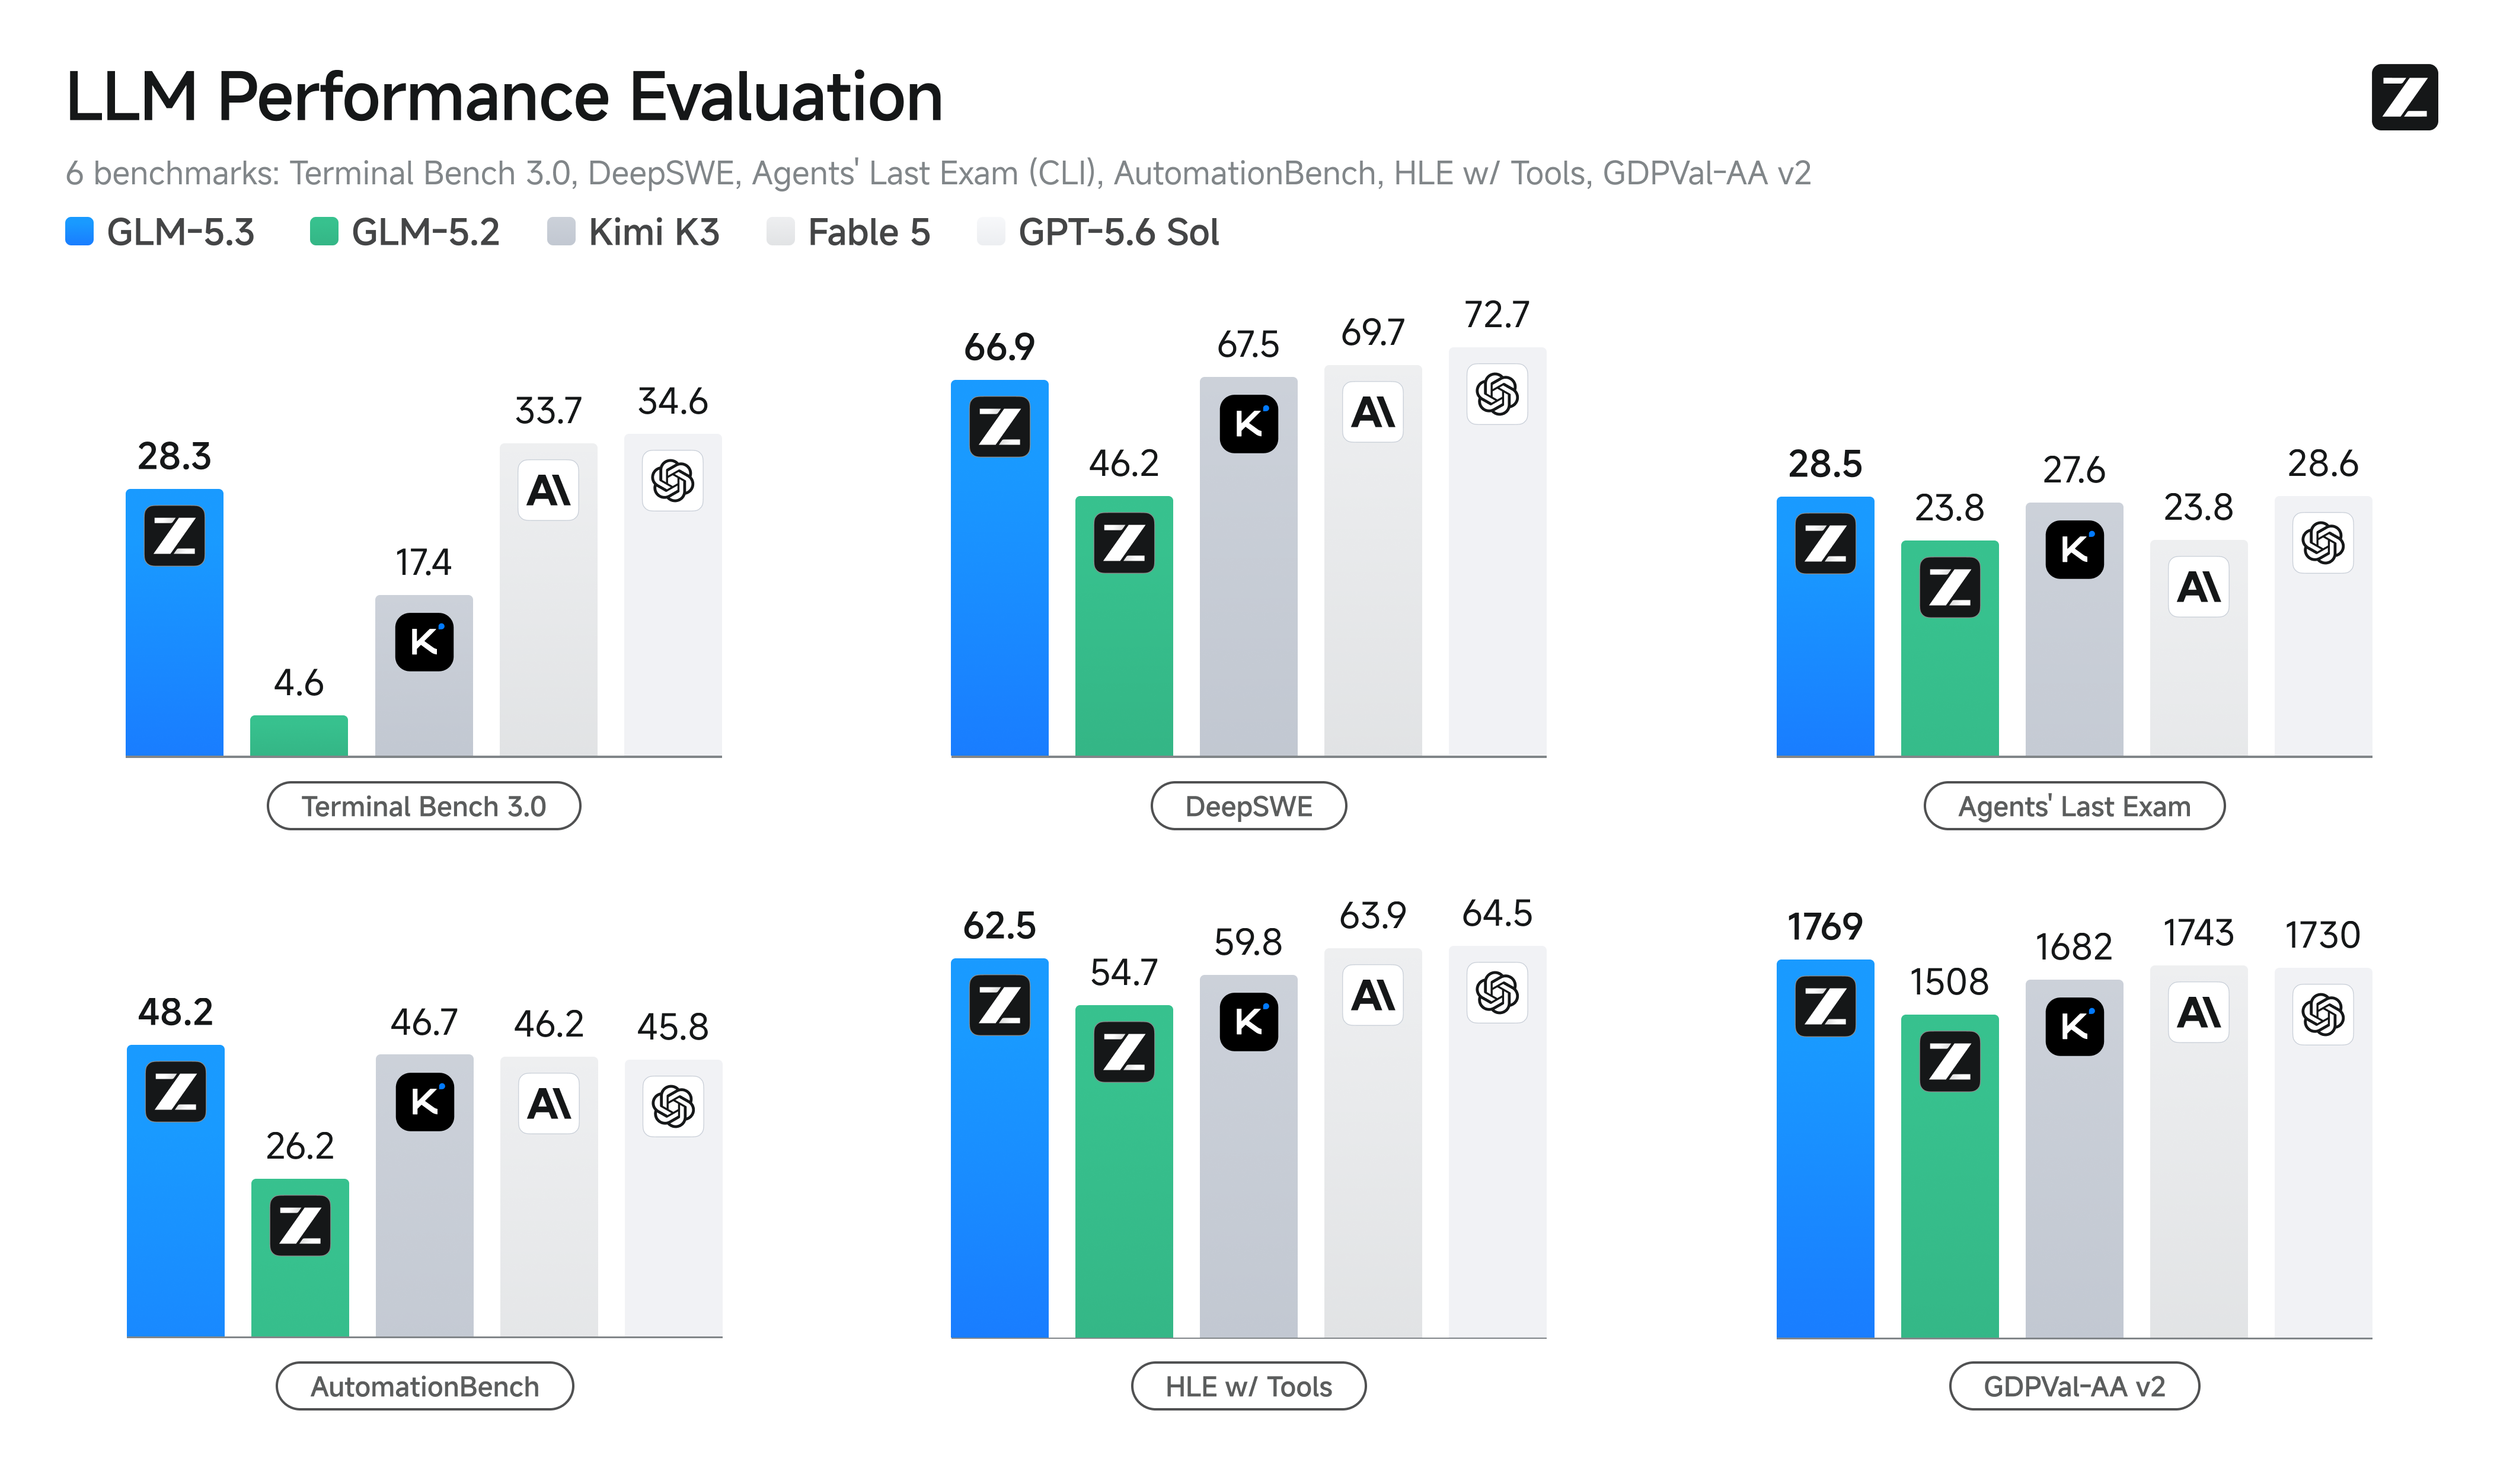
在多项主流基准上,GLM-5.3 都是当前排名最高的开源模型:Terminal-Bench 3.0(真实终端环境复杂任务)得分从 4.6 跃升至 28.3;DeepSWE v1.1(长程软件工程与持续代码修改)从 46.2 提升至 66.9;Agents' Last Exam(跨工具协作与长程任务)从 23.8 提升至 28.5;覆盖 44 种职业真实高价值知识工作的 GDPval-AA v2 中得分 1769。官方评价是:编程体感超过其他国产模型,智能体能力接近 Claude Fable 5。
2. 成本与效率:更短的执行路径
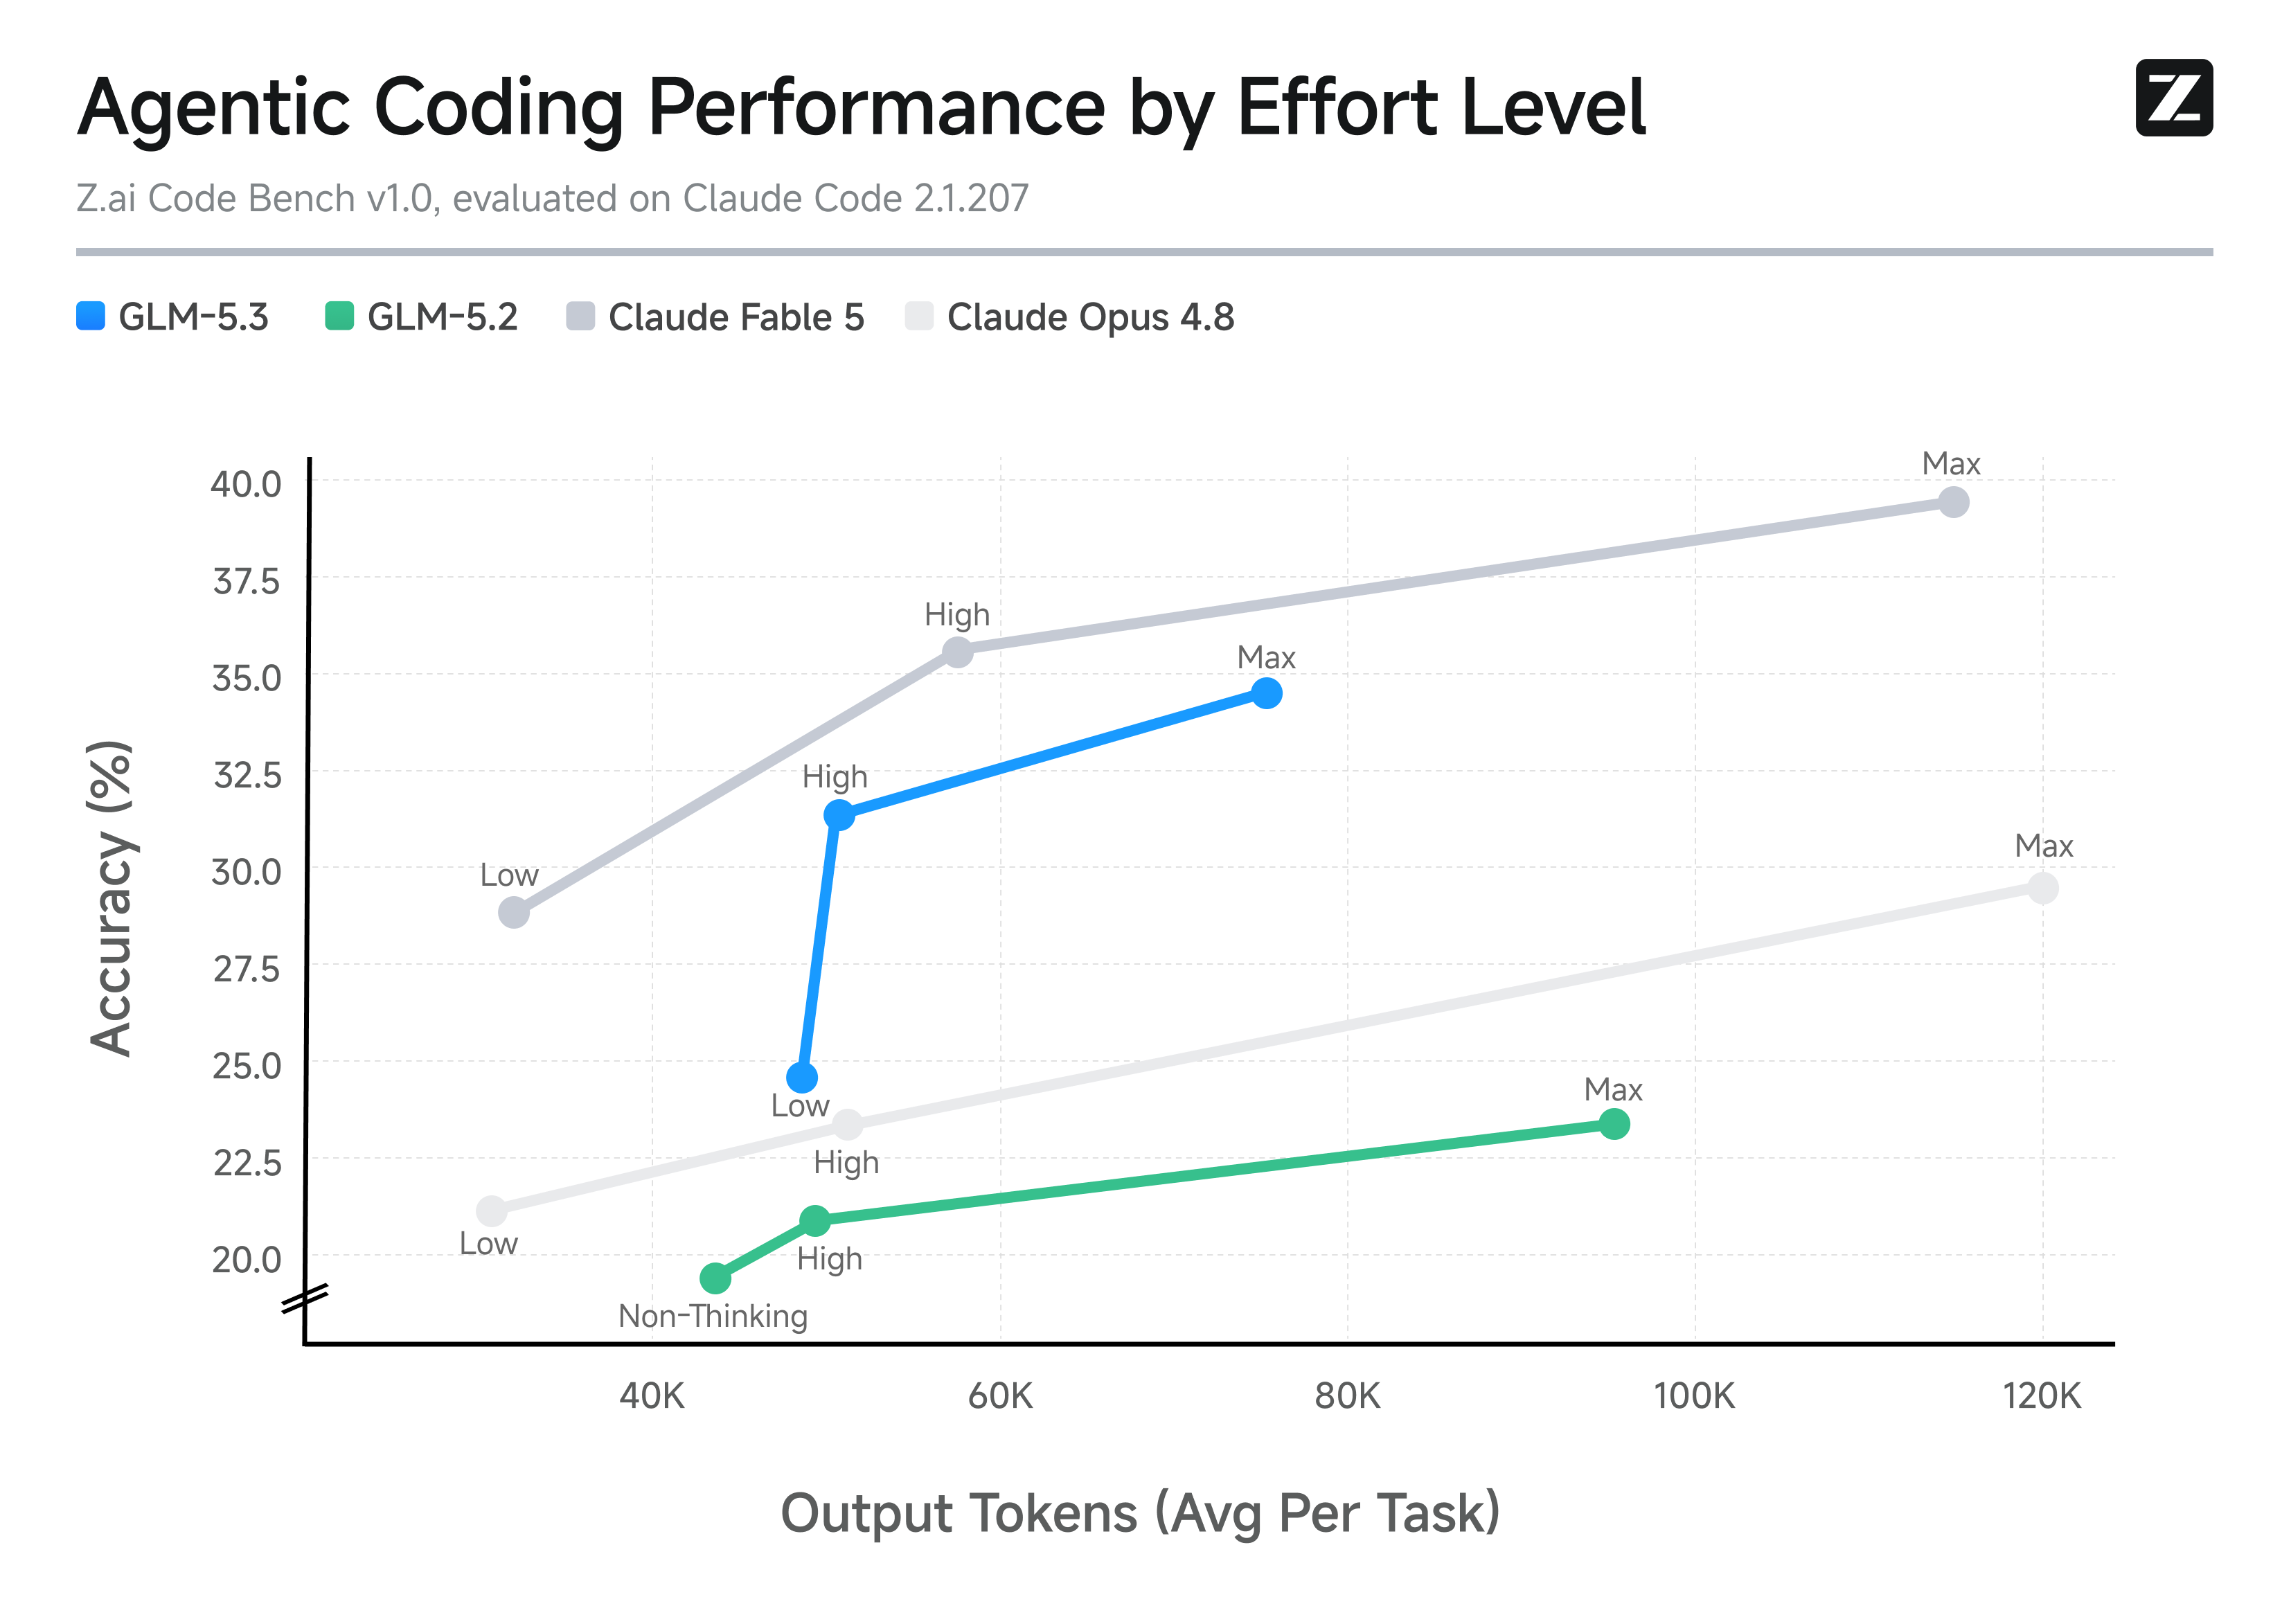
智谱自研的 Z.ai Code Bench 把模型放进复杂本地开发环境,按不同思考档位执行端到端任务。结果显示 GLM-5.3 在效果与 Token 利用率之间取得更好平衡:High 档位准确率 31.4%,超过 Claude Opus 4.8 最高档位的 29.5%;每项任务平均输出约 5 万 tokens,而 Opus 4.8 需要约 12 万 tokens——用更短的执行路径完成任务,这正是「成本更低」的底层来源。
3. 涌现的网络安全能力:防守端持平闭源前沿
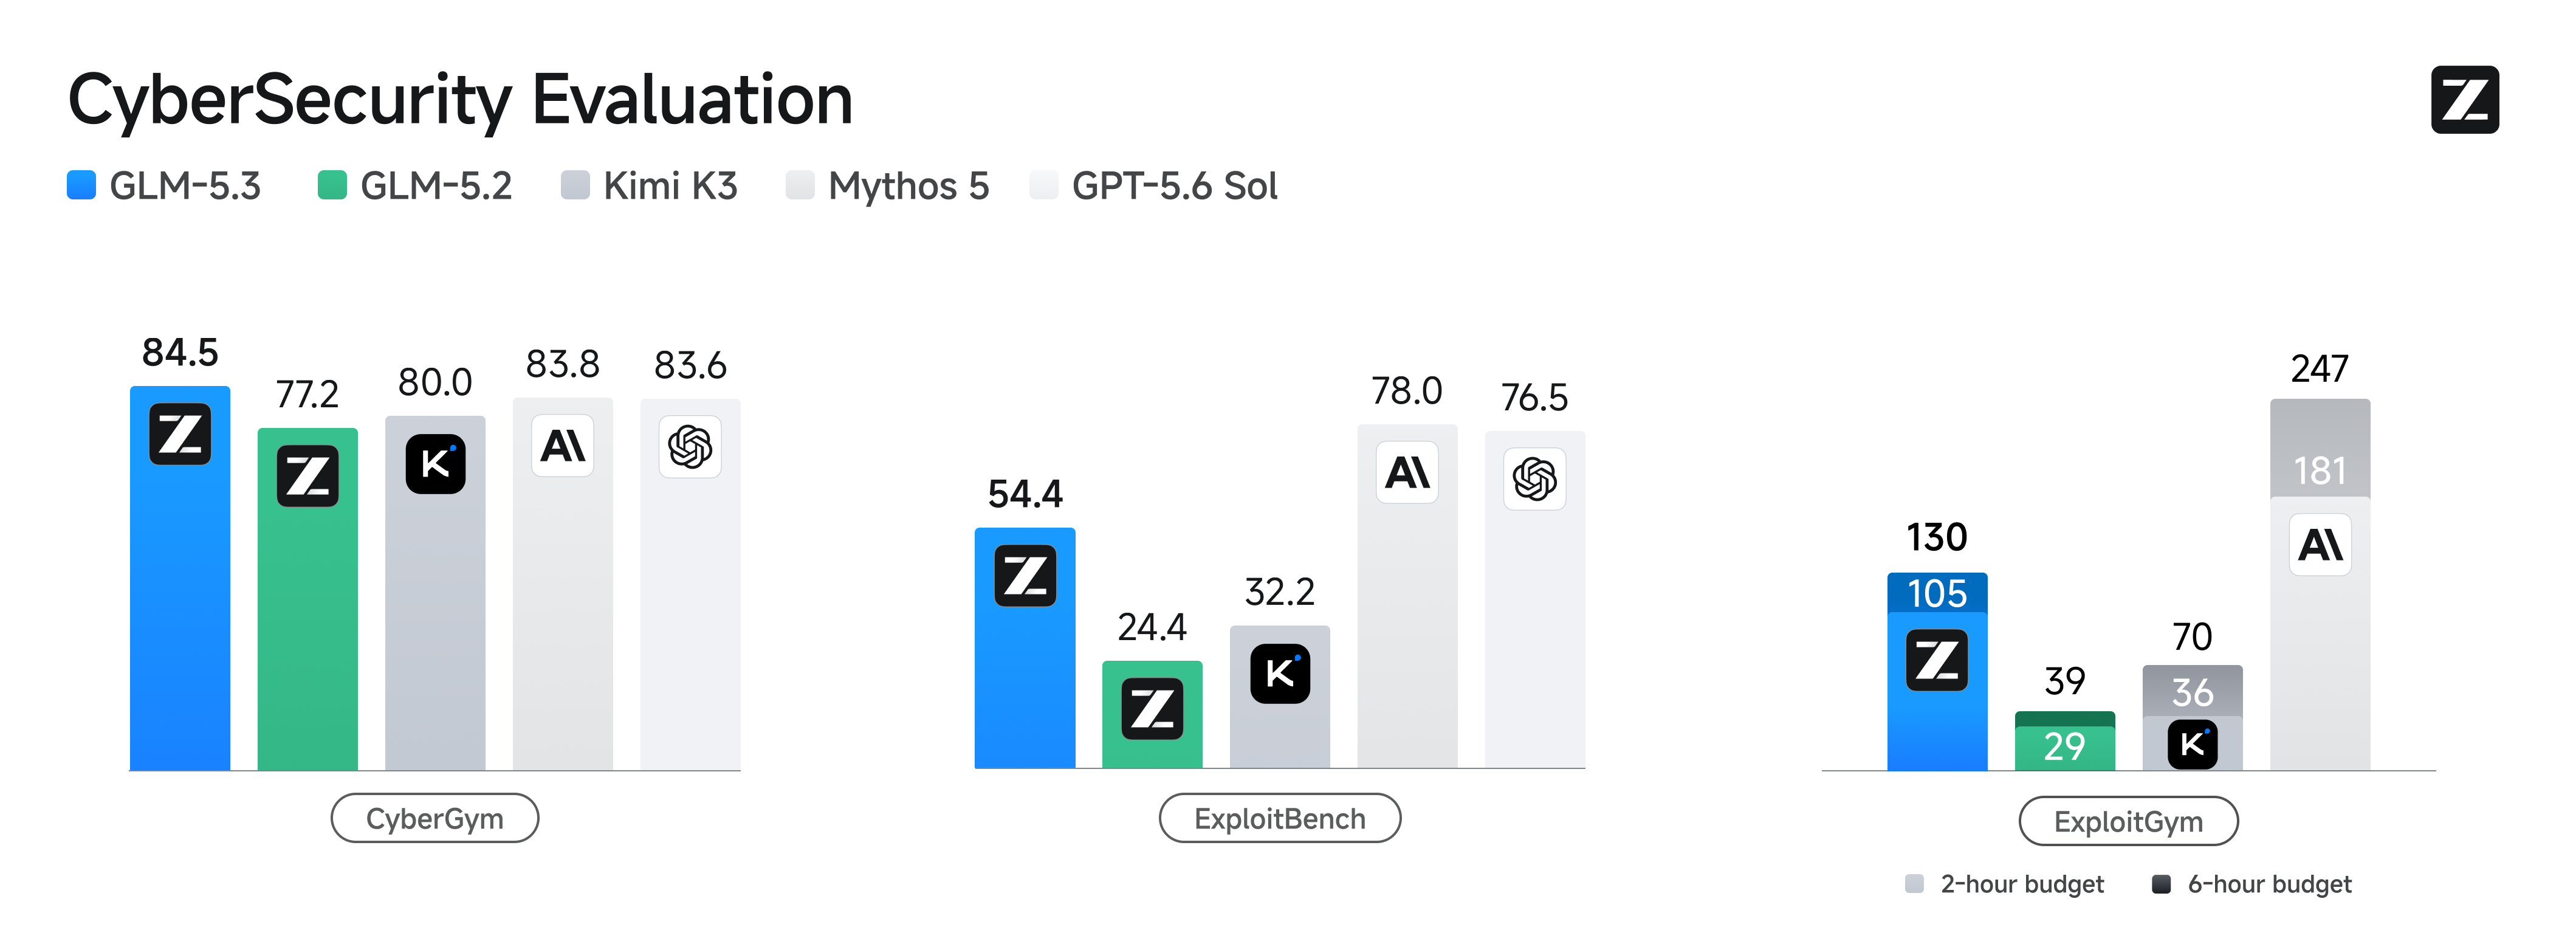
在覆盖漏洞分析、验证与利用三个阶段的评测中:CyberGym(白盒代码审查与漏洞验证)得分 84.5%,高于 GLM-5.2 的 77.2%,也略高于 Mythos 5 的 83.8% 和 GPT-5.6 Sol 的 83.6%;ExploitBench(深度推理下的漏洞利用)54.4%,是 GLM-5.2(24.4%)的两倍多;ExploitGym(限定时间漏洞利用吞吐)两小时完成 105 项、六小时 130 项,GLM-5.2 同期分别只有 29 和 39 项。趋势很清晰:越接近漏洞利用链前端(审查、验证),开源模型与闭源差距越小;越深入完整利用,差距越大。
4. 安全审计成果:2436 个漏洞与「开源的盾」计划
智谱联合清华大学、南开大学及云起无垠、绿盟科技、赛博昆仑、奇安信、安恒信息、腾讯玄武等团队开展密集红队测试,累计发现漏洞 2,436 个(初筛去重后),其中 1,097 个为中高危,覆盖系统内核、浏览器引擎、开源组件与互联网协议等 269 个项目,最早的漏洞可追溯至约 45 年前。按 Zerodium、Crowdfense、Pwn2Own 等市场公开报价估算,这些漏洞的经济价值达 3,000 万元。官方同步启动「开源的盾」计划:对重点开源项目持续安全审计、向维护者免费提供模型额度,并在 ZCode 中内置代码审计功能。
「没有开源反而是这个时代最不安全的事情。当最强的矛被锁在少数人手里,最好的盾必须属于所有人。」
四、各方反应
安全社区:清华大学 NASP 实验室借助 GLM-5.3 对 Cursor 的 Rust 与 Electron 混合架构做逆向分析,发现潜在失陷风险(任意文件写入、开发环境接管),漏洞已上报 CNVD/CNNVD;赛博昆仑发现三枚微软重大漏洞(邮件预览、文档处理、服务端远程访问),微软官方致谢「Kunlun Lab&GLM」;DARKNAVY 的 deepsec 系统则用 GLM 模型在一家顶级具身智能机器人厂商系统中发现可远程劫持上千台机器人的致命漏洞。
生态动作:GLM-5.3 即日起上线智谱官方编程工具 ZCode、效率工具 AutoClaw,GLM Coding Plan 向全量用户开放订阅;TraeWork/TraeCode、扣子、WorkBuddy/CodeBuddy、Qoder/QwenWork、CatPaw、JoyCode、OpenCode 等 7 个以上编码平台开放抢先体验——这是开源模型少见的「发布即铺开」节奏。
开发者社区:讨论集中在两个方向——「AA 智能指数 60 分并列开源第一」的含金量(评测口径与榜单稳定性);以及开源权重与安全加固的平衡(两周延迟开源 + 分层风险审查系统:外层分类器、推理监控器、深度安全对齐三层防线)。
五、深度解读:这意味着什么?
后训练 Scaling 成为开源模型的新主战场
GLM-5.3 用同一个基座证明了「智能上界远未到顶」——这是对「开源模型只能靠堆参数追赶」论调的有力反驳。当闭源厂商继续卷预训练算力时,开源阵营找到了更经济的路线:把强化学习环境做到「工程师连续数天的工作量」级别,让模型在完整工作流中学会发现问题、分析、验证到交付。
安全能力成为开源模型的分水岭
智谱把网络安全定义为「约束严格的编程能力」,并选择把攻防能力以开源形式扩散——这与 Anthropic 向约 150 家大型机构提供 Mythos 安全服务的闭源路线形成正面分歧。谁能定义「负责任的开放」,谁就将在企业级与国家级 AI 采购中占据话语权。
价格战叠加能力战,格局加速重构
8 月中旬 DeepSeek V4 Pro、GLM-5.3、Qwen3.8 密集落地,与 OpenAI/Anthropic 的价格战互相咬合。当开源模型的编程体感接近闭源、成本显著更低,企业「自托管 + 闭源 API 混合」的采购策略会进一步挤压闭源厂商的定价空间——下一个季度的 API 价格表值得紧盯。
六、总结
GLM-5.3 用「不换基座」的后训练 Scaling 换来编程能力提升 50%、安全能力持平闭源前沿——开源模型竞争的维度,正从参数规模转向后训练深度与安全责任。