一、导语
2026 年 8 月 26 日晚 23:00,通义千问按 ModelScope 倒计时页面的预告时间准点开源 Qwen3.8-Flash-Next。这不是一次普通的版本迭代:这是一款 125B 总参数、每 token 仅激活 6B 参数的多模态 MoE 模型,官方明确定位为 Qwen4 所用模型结构的「先导预览」——承担的角色,与当年 Qwen3-Next 之于 Qwen3.5 完全一致。相比 Qwen3.7-Plus,它的训练开销只有约 1/9,编码与办公智能体能力却更强:SWE-bench Pro 拿下 62.5 分反超 Claude Opus 4.6,CoWorkBench 73.9 分领跑同组对比。生产版本 Qwen3.8-Flash 同步上线千问 AI 平台,输入价格压到每百万 tokens 0.8 元。
二、背景分析:为什么提前开源一套架构?
Qwen 团队的逻辑很直白:Qwen3-Next 当年引入的 Gated DeltaNet + Gated Attention 混合结构,此后被 Qwen3.5、3.6、3.7、3.8 全系列沿用——「先放架构、再建家族」的路径已经被验证过一次。这次他们把 Attention、Residual、Embedding、Optimization 四个方向的结构改动同样提前释出,让社区在 Qwen4 完整模型家族构建之前先行检验。
更大的背景是,开源模型竞争已进入「效率战」阶段:智谱 GLM-5.3 用后训练 Scaling 把编程能力提升 50%,蚂蚁 Ling-3.0-flash 以 5.1B 激活参数对标 1T 旗舰,腾讯混元 Hy4 preview(770B 总参、1M 上下文)也在同一周开源上线。「每 token 激活参数」正在取代「总参数」成为新的军备竞赛指标——谁用更少的算力办同样的事,谁就能在价格战里活到最后。
三、核心内容:四大架构升级与真实数据
1. 参数结构:小而锐利的 MoE
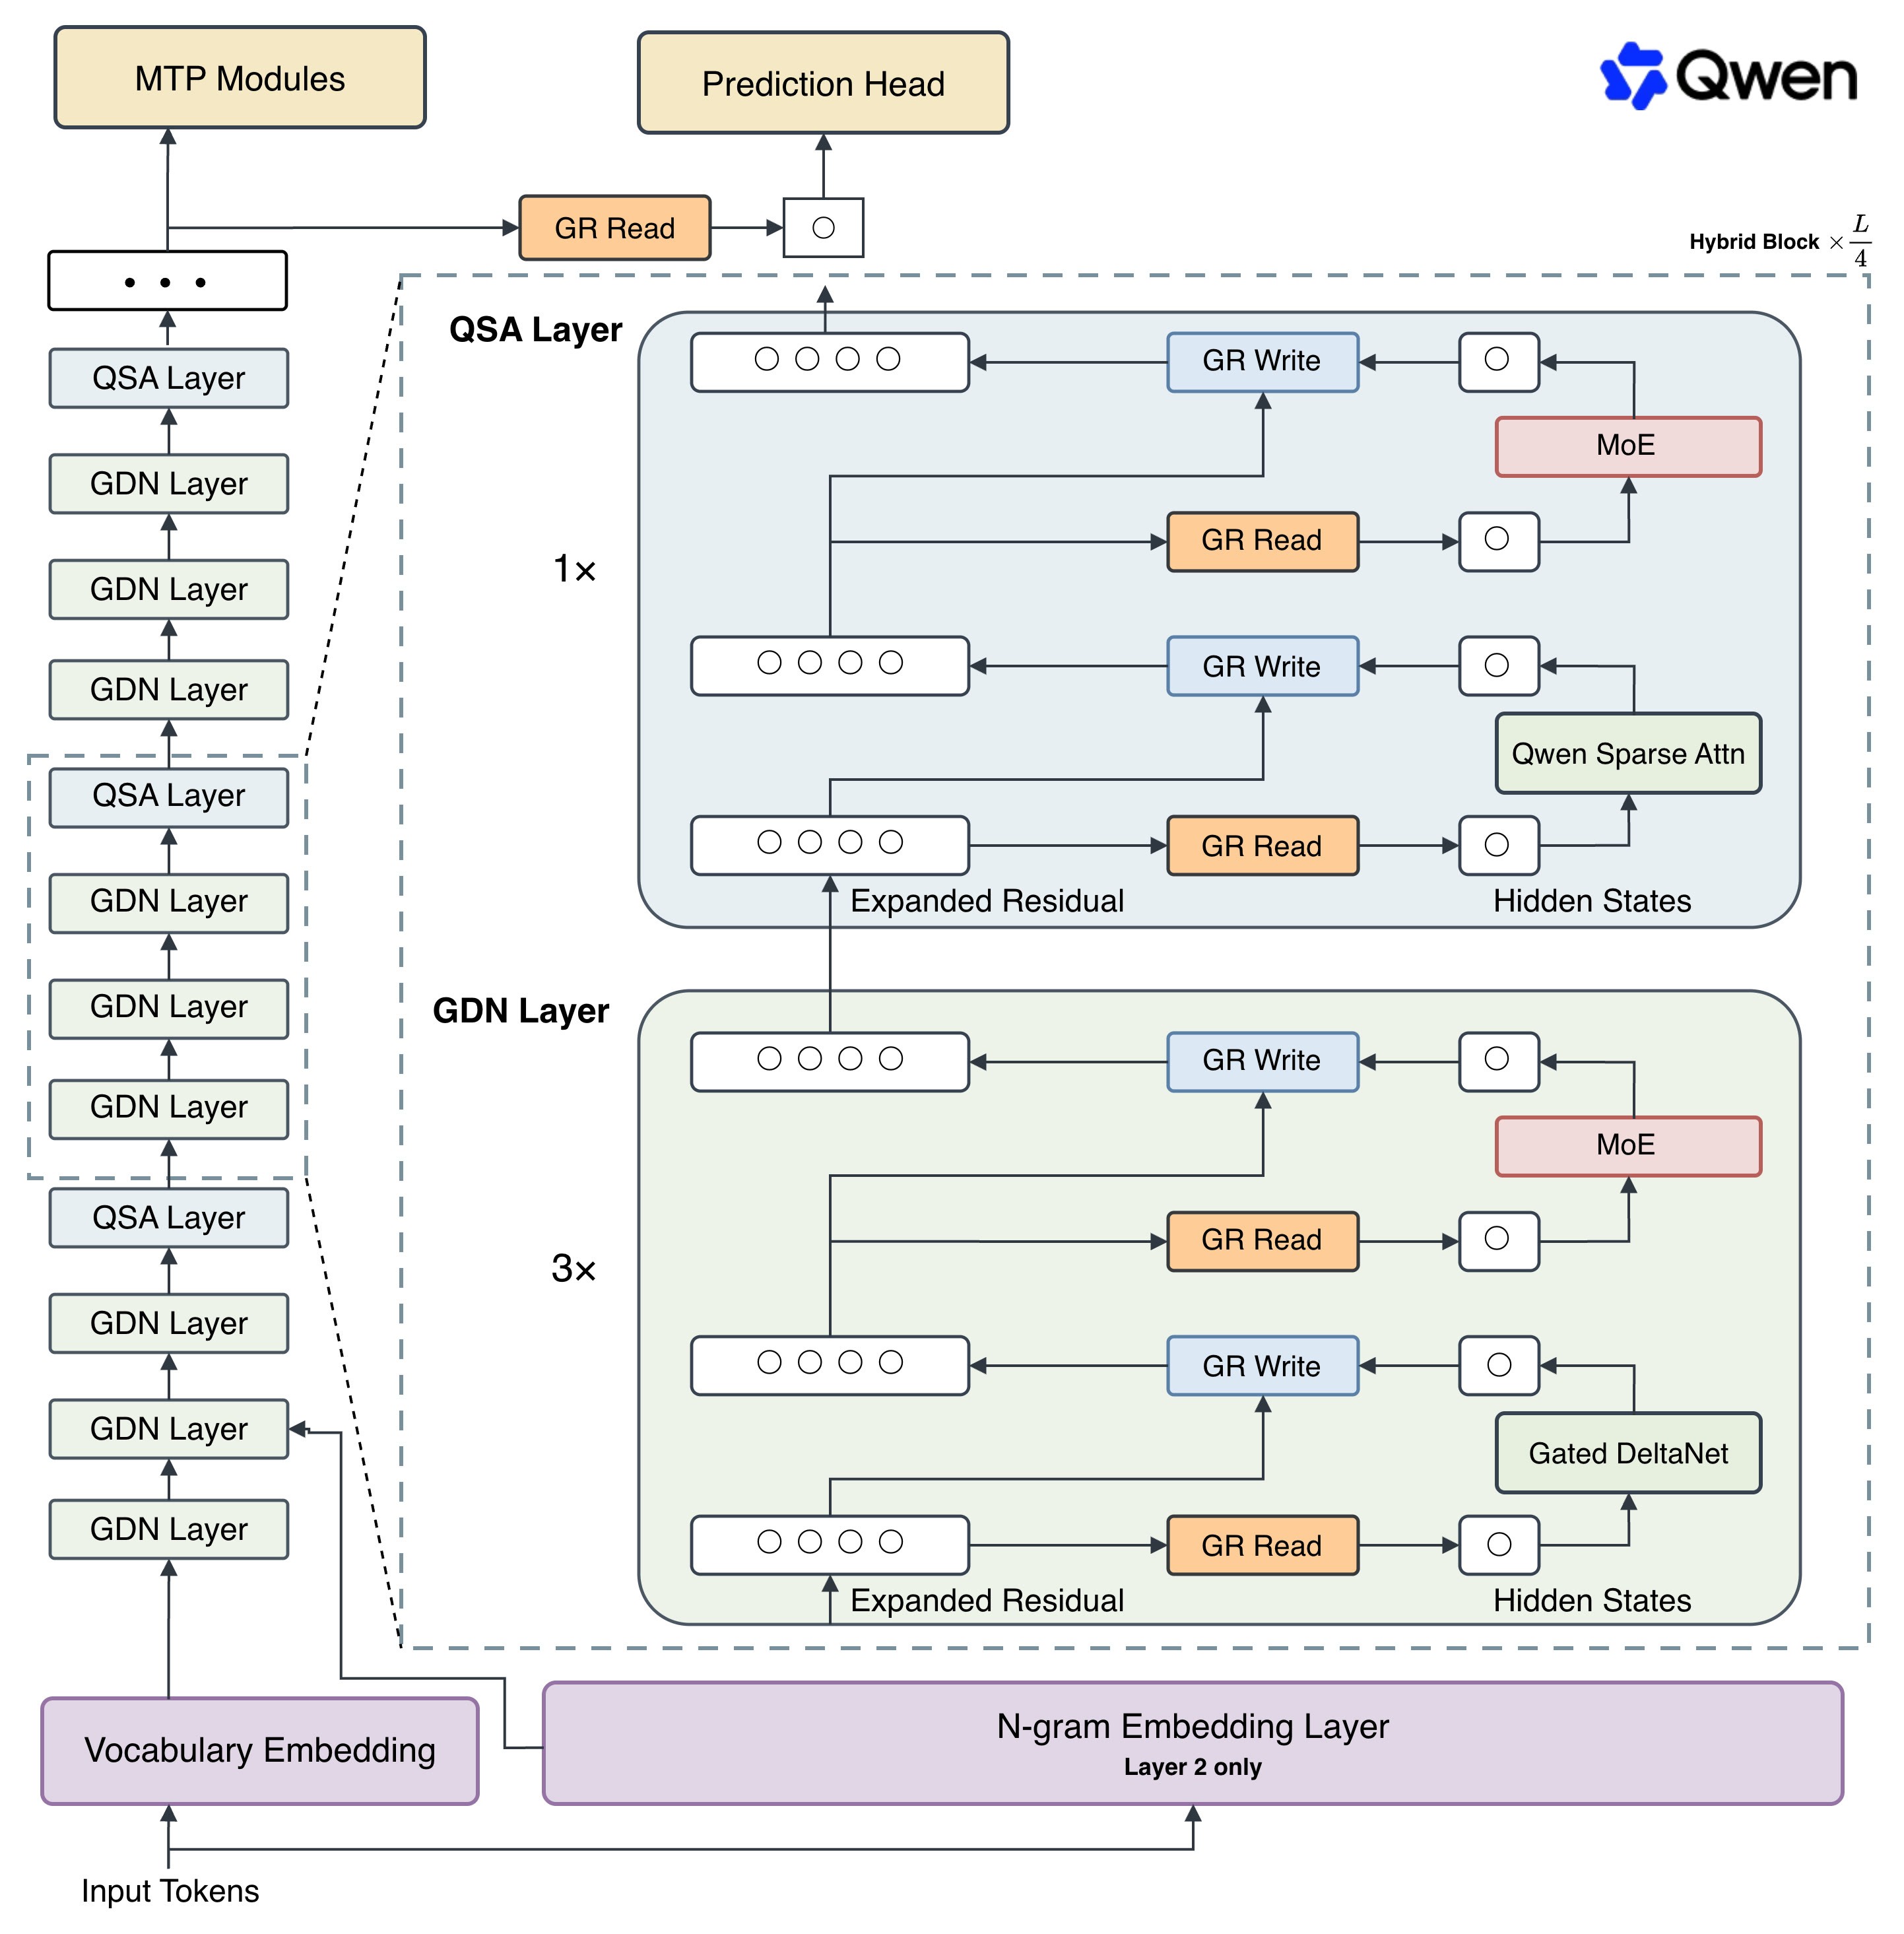
Qwen3.8-Flash-Next 由 125B 主模型 + 51B N-gram Embedding + 4B MTP(多 token 预测)层构成,共 512 个专家,每 token 只路由 10 个专家并配 1 个共享专家,共 48 层。原生支持 262,144 token 上下文,通过 YaRN 可扩展至 1,000,000 token,并内置视觉编码器,是标准的图文多模态模型。
2. Attention:QSA 稀疏注意力 + Gated DeltaNet
核心改动是 Qwen Sparse Attention(QSA):Gated DeltaNet(GDN)负责高效压缩历史信息,一个压缩式轻量 Indexer 在 micro-block 粒度上筛选重要上下文,显著降低长序列 Attention 开销——不再对每个 token 都做全量注意力,这正是长上下文场景下延迟与显存的大头。
3. Residual 与 Embedding:容量与显存解耦
Gated Residual 把 Residual Stream 扩展为 4 条分支,通过动态 Gate 控制信息读写,Residual State 还支持 FP8 存储。Embedding 层面借鉴 Gemma 3n 的 Per-Layer Embedding 与 DeepSeek Engram 思路引入 N-gram Embedding:结合当前 token 与前几个 token 组成的局部上下文查表,51B 参数可以存放在 Host Memory 中,通过异步 Prefetch 与模型计算重叠,不长期占用 GPU 显存——模型容量与推理显存首次被拆开。
4. Optimization:Muon 优化器与「去掉 Batch Size Warmup」
训练端使用 Muon 优化器,并围绕正交化精度、Muon 与 AdamW 的参数分工、融合参数矩阵拆分做工程优化;针对新结构重新拟合 Scaling Law 后,模型可以稳定使用更大的学习率与 Batch Size。实验还发现过去常见的 Batch Size Warmup 已无必要——它只会额外消耗 18.8% 的 optimizer steps,最终训练配置直接从目标 Batch Size 开始。
5. 基准与定价:反超闭源旗舰的性价比
Agentic 编程上,DeepSWE 1.1 得分 58.7(Qwen3.7-Plus 仅 16.5、DeepSeek-V4-Flash-0731 为 54.4);SWE-bench Pro 62.5,高于 Claude Opus 4.6 的 53.4;SWE-bench Multilingual 81.0。办公智能体方面 CoWorkBench 73.9、JobBench 55.7(Qwen3.8-27B 仅 33.4)。Base 模型在 14 个 benchmark 的 8 个上取得最优。定价上,生产版 Qwen3.8-Flash 默认 1M 上下文并内置工具,每百万 tokens 输入 0.8 元、输出 2.7 元。
「我们此次发布 Qwen3.8-Flash-Next 的开源权重……提前释出结构上的改动,以便在其上构建 Qwen4 完整模型家族之前,先让社区对其进行检验。」
四、各方反应
中文社区:知乎作者将这次发布称为「一份架构金丝雀」——ModelScope 当天下午先挂出倒计时页面,晚间 23:00 准点开源,围观与讨论集中在「6B 激活参数能否撑起旗舰级 Agent 表现」上;GitHub 仓库(QwenLM/Qwen3.8-Flash-Next)上线两天即收获 229 颗 star。
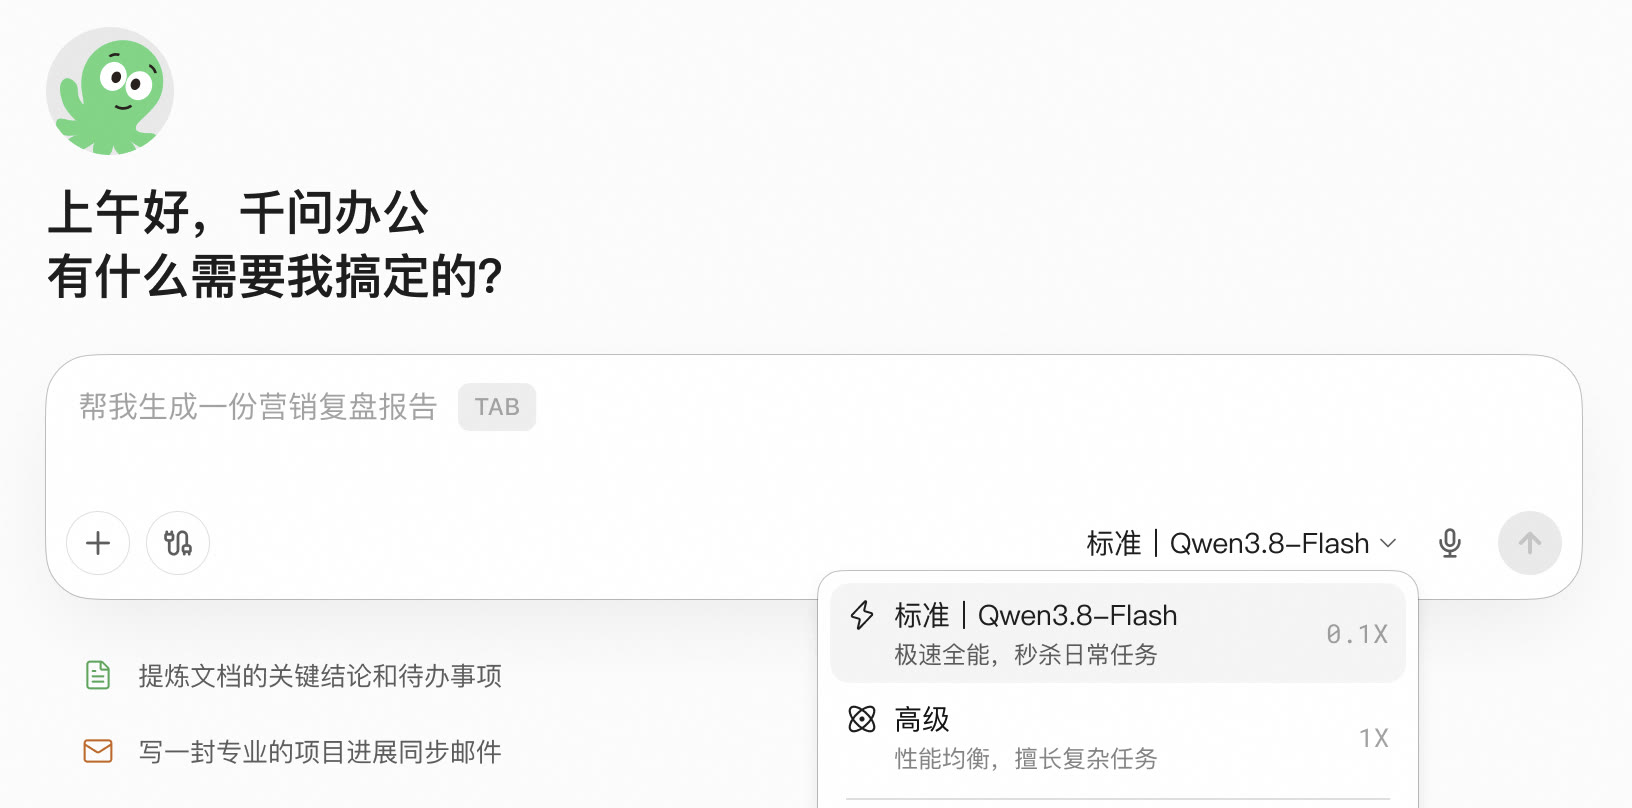
生态联动:千问办公的全新「标准」模式直接接入该模型,主打 Agent 智能水平、推理效率、成本控制三位一体;API 同时兼容 OpenAI 与 Anthropic 协议,可直连 Claude Code 与 Codex 使用,等于把最流行的两个编程 Agent 入口都打通了。
谨慎声音:海外评测媒体提醒,这些仍是厂商自报基准、未经独立验证;且本地部署门槛不低——社区构建的 GGUF 即便是 1-bit 量化仍需约 123GB 存储,普通开发者大概率只能走 API。
五、深度解读:这意味着什么?
1. 效率本身就是下一代架构的竞争力
6B 激活参数 + 1/9 训练成本意味着「更强的模型」和「更低的价格」可以同时成立。当输入价压到每百万 tokens 0.8 元,长上下文 Agent 的 token 账单会指数级下降——这会直接挤压闭源厂商的定价空间,重演 2025 年 DeepSeek 引发的价格战。
2. 开源社区成为架构检验场
Qwen 选择在 Qwen4 之前把核心结构开源,本质是把全球社区变成免费的架构测试、性能验证与生态预热渠道。Qwen3-Next 模式已被证明有效:提前放出结构,让社区用一年时间打磨,再以完整家族收割成果。
3. 长上下文智能体成本正在「解耦」
QSA 稀疏注意力 + 可卸载到 Host Memory 的 51B 查表 Embedding,指向同一个目标:把长上下文 Agent 场景中「记忆」和「计算」的成本拆开。这可能是下一轮模型架构竞争的真正主战场。
六、总结
Qwen3.8-Flash-Next 用 6B 激活参数和 1/9 训练成本证明:效率本身就是下一代架构的竞争力——Qwen4 的底牌,已经提前翻给了整个行业。