一、导语:开源权重第一次贴住闭源旗舰
10 月 23 日,月之暗面发布 Kimi K3.1 Pro。三个数字放在一起就够说明问题:3T 级参数规模、100 万 token 上下文、11 月 4 日前释出完整权重。在 Terminal-Bench 4.0 上它拿到 65.7%,Claude Opus 5.5 是 66.4%,GPT-6 Astra 是 58.2%。
这不是「开源模型又进步了」那种进步。过去两年,开放权重模型的标准剧本是:榜单上落后半个身位,价格便宜一个数量级,靠性价比活在闭源旗舰的阴影里。K3.1 Pro 把这个剧本改了一半——价格仍然便宜,但在编码 agent、长程任务、含工具的知识问答上,它已经站在同一张桌子边上。
二、背景:不是新模型,是一次把后训练算力堆到底的重训
官方博客写得很直白:K3.1 Pro 是 Kimi K3 的后训练版本,但后训练算力「大幅增加」。为了让这套算力真的换成能力,月之暗面重做了整个栈——RL 框架、长上下文推理、训练效率、沙箱基础设施、rollout 调度,以及一套共享的环境质量校验平台,目标是让每一份 RL 算力都带来稳定可预测的回报。
这条路线和 2026 年开源阵营的整体节奏对得上。DeepSeek 的 V4.1 Flash 系列、智谱 GLM-5.3 都在这几个月内密集迭代,方向一致:基座不动,把后训练和 agent 环境做到极致。差别在于 K3.1 Pro 把规模推到了 3T 级,并把上下文拉到 100 万 token——这两个指标过去是闭源模型的护城河。
“我们优化了栈的每一层,让 RL 算力的每一次增量都带来稳定、可预测的回报。结果是 K3.1 Pro 在每个领域都取得了一致的提升。”
三、核心内容:榜单数据与定价
先看最硬的几组对比。Terminal-Bench 4.0 测的是编码 agent 在真实、资源受限的终端任务上能否通过严格的任务级测试,K3.1 Pro 65.7%,落后 Opus 5.5 仅 0.7 个百分点,领先 GPT-6 Astra 7.5 分。SWE Marathon 上它以 51.7% 直接排第一,Opus 5.5 是 46.3%。Agents' Last Exam 43.2%,同样第一。Humanity's Last Exam(含工具)78.0,Opus 5.5 67.7。
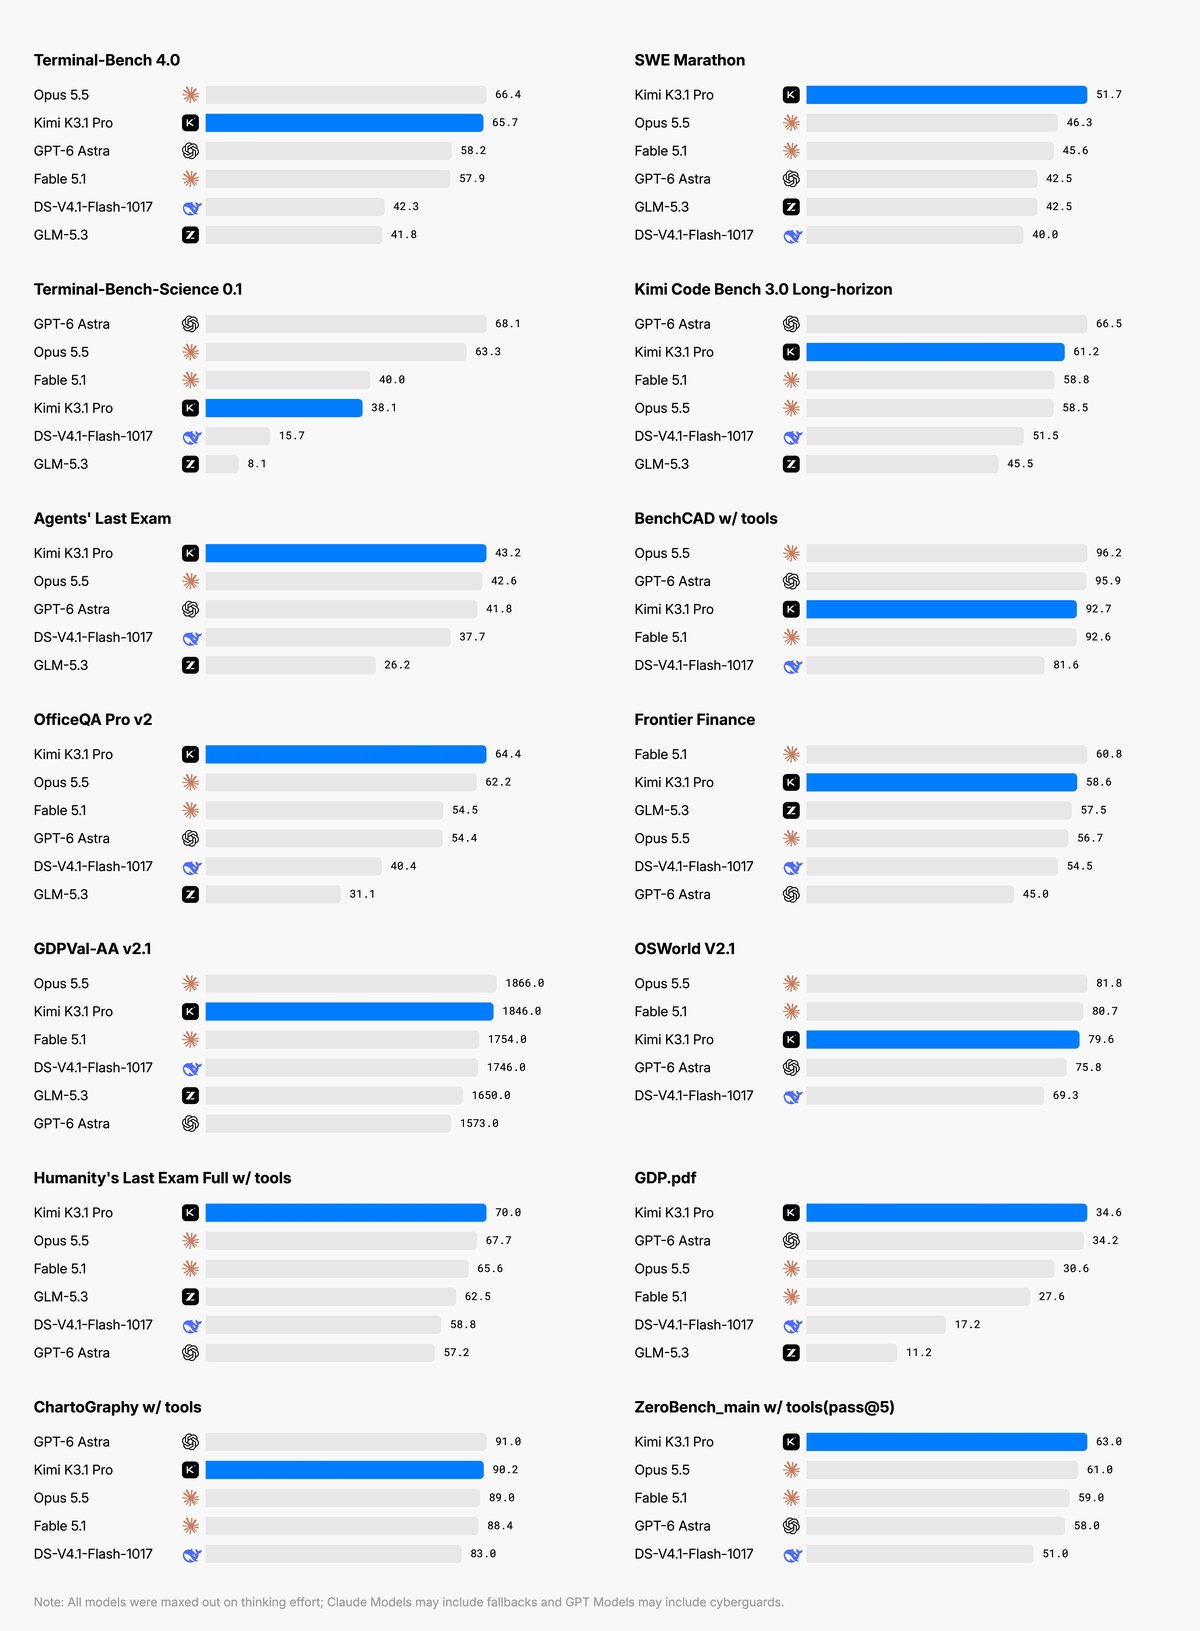
也有打不过的地方,博客没藏。Terminal-Bench-Science 0.1 上 K3.1 Pro 只有 38.1%,GPT-6 Astra 是 68.1%,Opus 5.5 是 63.3%——差了近 30 分。ChartoGraphy 90.2 对 GPT-6 Astra 的 91.0,GDPval-AA 1846 对 Opus 5.5 的 1866,都是「接近但没赢」。BenchCAD(多视图渲染反推 CAD 代码)92.7%,Opus 5.5 96.2%。
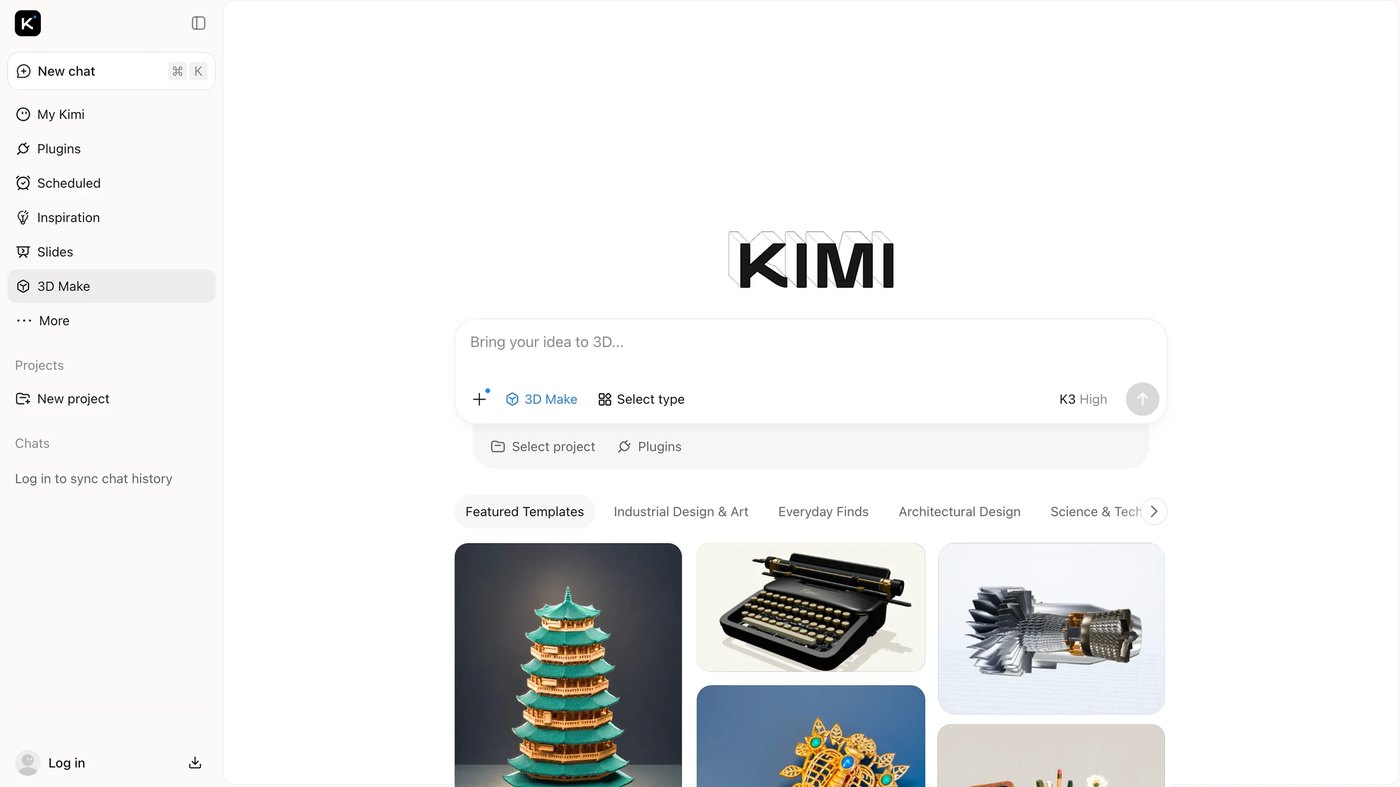
垂直场景的数据更值得看。财务方向,OfficeQA Pro v2 拿 64.4 分称 SOTA,内部财务研究基准比 K3 提升 11.6 分,商业运营模拟提升约 4.2 倍。幻觉率这块,官方内部压力测试 Kimi Hallu Bench Hard 上,claim 级幻觉率从 K3 的 23.4% 降到 8.3%。3D 方向则顺手把产品做了:3D Make 已在 kimi.com 和 App 上线,可直接预览编辑、导出 3D 打印文件或视频。
价格是这次最直接的信号。API 每百万 token 输入 13 元、输出 68 元,相比 K3 基本砍半;OpenRouter 上的挂牌价是 $2 / $10。同时推出 K3.1 Pro Highspeed,速度约 2–3 倍、价格翻倍。上架渠道一次性铺满:kimi.com、Kimi App(iOS / Android / HarmonyOS)、Kimi Work 桌面端 3.1.0+、Kimi Code(/model 切换)、Kimi API,企业版默认关闭需管理员开启。
四、各方反应:第 4 名,和一个被主动砍掉的能力
第三方评测机构 Artificial Analysis 给出的 Intelligence Index 是 55 分,排第 4,比 Kimi K3 高 11 分,前面只剩 Claude Opus 5.5、Claude Sonnet 5.5 和 Muse Wonder Full。对一个权重即将公开的模型来说,这个位置此前没有出现过。OpenRouter 当天就挂上了 1M 上下文的多模态版本,定位写的是「长程编码与 agent 任务」。
真正有意思的是安全那一节的自曝。博客承认:随着后训练规模上去,模型的漏洞研究能力一路走高,追查后发现网络攻击相关内容混在中训练语料和 RL 环境里。于是他们在两个训练阶段都做了数据清洗,再拿内部基准 xdev-bench-hard 测——不清洗的 checkpoint 能解 90.5% 的题目(pass@3),清洗后的正式版是 81.0%。也就是说,他们主动砍掉了近 10 个百分点的攻击能力才敢开源。
博客同时给了两条边界:不发布会推高网络攻击能力绝对前沿的权重;但会逐步提高开放权重里的这部分能力,理由是防御方需要能在自己控制的机器上审代码。这话在 Black October 刚过去的语境里,等于往火上又添了一点柴——同一个星期,AI 辅助挖出的 PHP 核心 RCE 正在被数百万次尝试利用。
五、深度解读:三个被改写的成本项
第一是部署成本。3T 级参数、开放权重,意味着有能力自建集群的团队第一次可以在前沿水平上做私有部署。对金融、医疗、政务这类数据不能出境的场景,这不是「便宜一点」,而是「能不能用」的问题。
第二是上下文经济学。100 万 token 配上 agent 能力,改的是工作流的形状——不是把长文档塞进去做摘要,而是让模型在一个仓库、一份财报、一整套 CAD 工程里连续跑几十步。K3.1 Pro 在长程编码上的提升(内部 Kimi Code Bench 3.0 从 55.95% 到 61.2%)就来自这里。博客里那个「人形行走模拟器」的例子很典型:167 个任务、420 次独立评审,模型发现奖励塑形无效后没有继续调奖励,而是去跑开环探针,找出并修正了肩部肌肉力臂计算里的 36 处错误,最终让人形连续行走 11.2 秒。
第三是开源与安全的定价权之争。K3.1 Pro 把「开源模型能不能碰前沿」这个问题从能力层面挪到了治理层面:能力已经有了,剩下的是发布者愿意放出多少、监管愿意接受多少。月之暗面选了「先砍攻击能力再开源」这条路,这套做法会成为后续所有中国实验室的参照系。
六、总结
一句话:Kimi K3.1 Pro 用 65.7% 的 Terminal-Bench 成绩和 11 月 4 日的权重日期证明,开放权重模型已经能站在闭源旗舰旁边——接下来决定格局的,不再是榜单差几分,而是有多少团队真的会把它部署到自己的机房里。